AI 추론비용을 줄인 발명은 어느 처리단계에서 완성되는가
핵심 요약
KV 캐시 최적화는 블록의 저장 위치를 정하는 문제와 제거할 토큰의 중요도를 평가하는 문제로 나뉩니다. Intel 공개항과 Qualcomm 등록항을 계산 예제로 비교합니다.
AI 서비스의 사용량이 늘면 응답 한 건의 비용과 지연시간이 제품 경쟁력에 직접 영향을 줍니다. 캐시를 조정하고 요청을 묶거나 모델을 나누어 비용을 낮췄다면, 그 과정에서 만든 기술을 출원 후보로 검토할 수 있습니다.
여러 최적화를 함께 적용한 경우에는 어떤 변경이 효과를 냈는지부터 나누어야 합니다. 비용·품질·속도의 변화를 자원 배분 기준과 처리 순서에 연결하면 같은 기반 모델을 쓰는 경쟁사와 구별되는 기술을 찾을 수 있습니다.
비용 감소는 출발점입니다
같은 모델에서도 요청을 묶는 방식, 중간 결과의 재사용, 모델 선택과 메모리 관리에 따라 운영 성능이 달라질 수 있습니다. 비용이 줄었다는 결과만으로는 어떤 발명인지 알기 어렵습니다. 요청의 어떤 특성을 읽고 자원을 어떻게 배분했는지를 찾아야 합니다.
비교 조건을 먼저 맞춥니다
작은 모델을 사용해 응답 비용이 줄었지만 품질이나 지연시간이 달라졌다면 같은 조건의 개선으로 보기 어렵습니다. 가상의 라우팅 기술이라면 어떤 요청을 작은 모델로 보내고, 어떤 결과에서 큰 모델로 전환하는지 설명합니다. 품질 기준과 전환 비용을 함께 기록해야 실제 효과의 원인을 볼 수 있습니다.
캐시의 대상과 갱신 조건을 구분합니다
질문 전체가 같을 때 답을 재사용하는 것과 중간 연산 일부를 공유하는 것은 다릅니다. 재사용 가능한 범위, 무효화 조건, 사용자별 데이터 격리 방법이 검토 지점이 될 수 있습니다. PagedAttention 같은 공개 연구와 비교할 때도 일반적인 메모리 효율화라는 목표보다 구체적 관리 구조를 대조해야 합니다.
캐시 축출에서 실제로 다른 것은 무엇을 점수화하는가
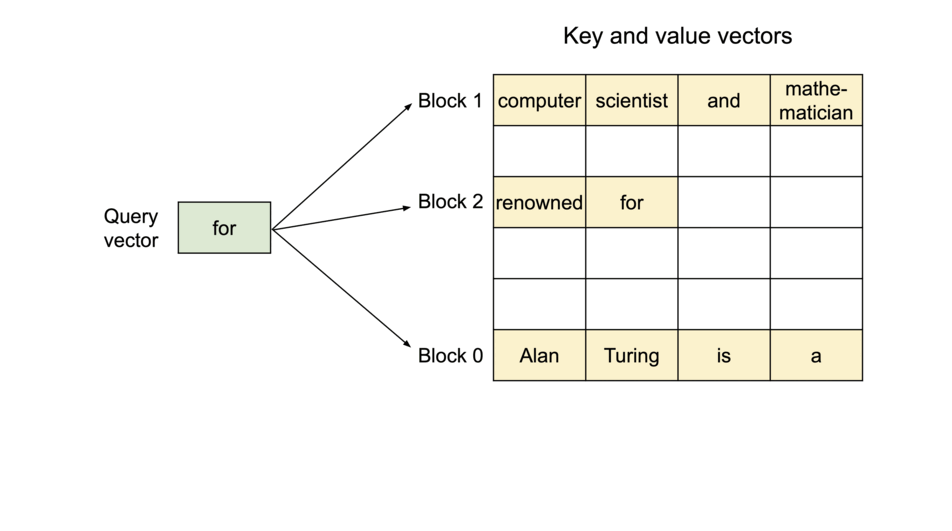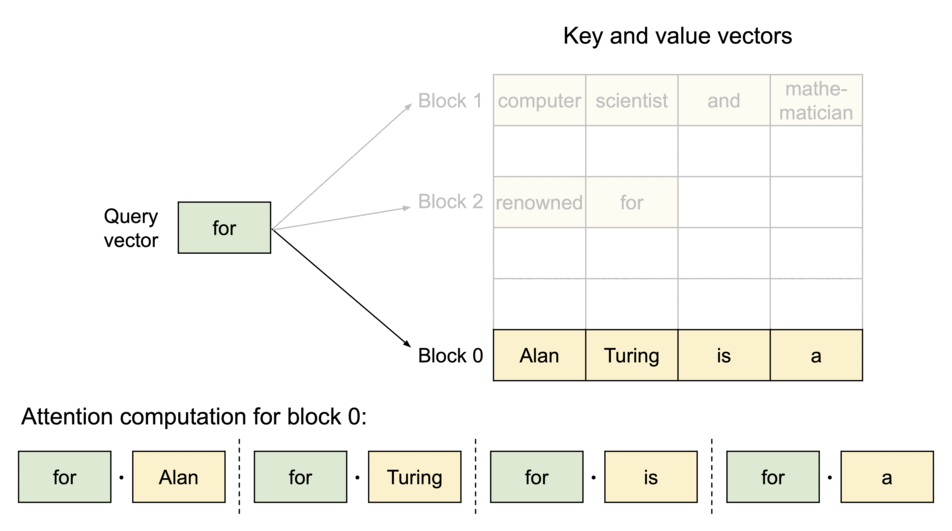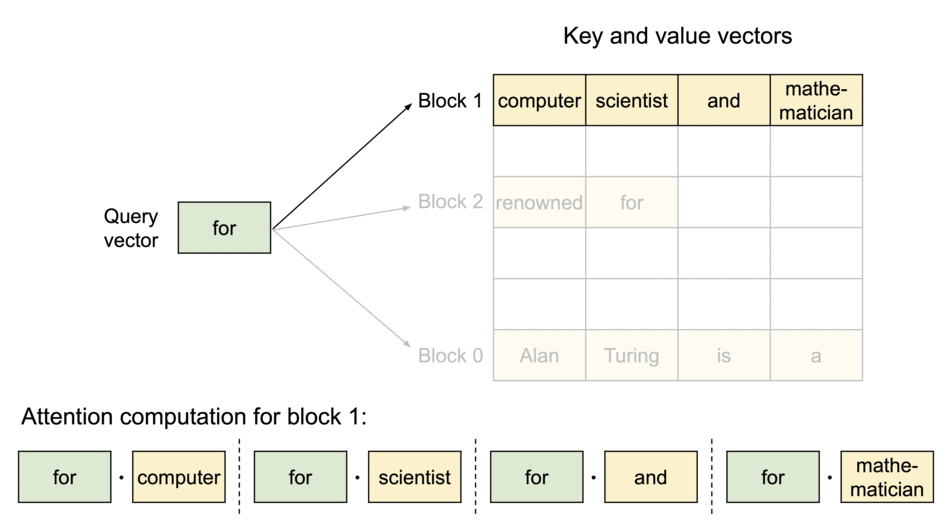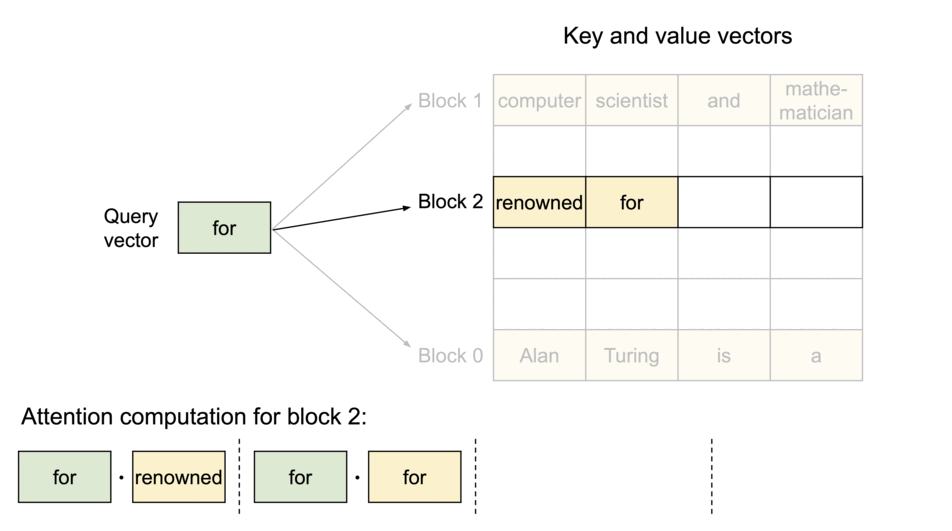
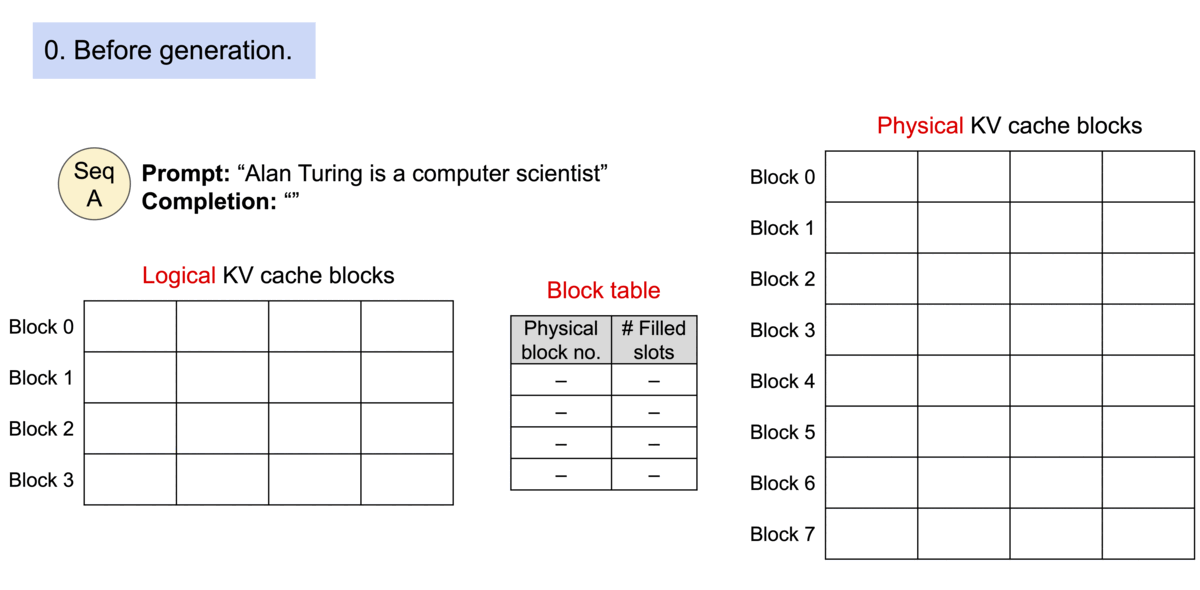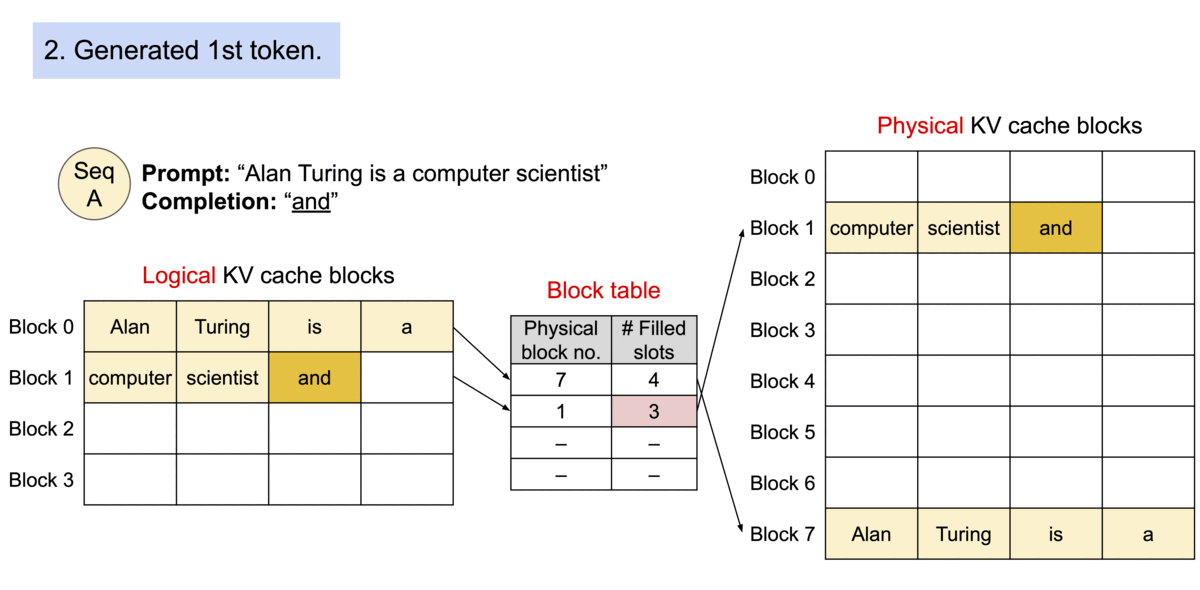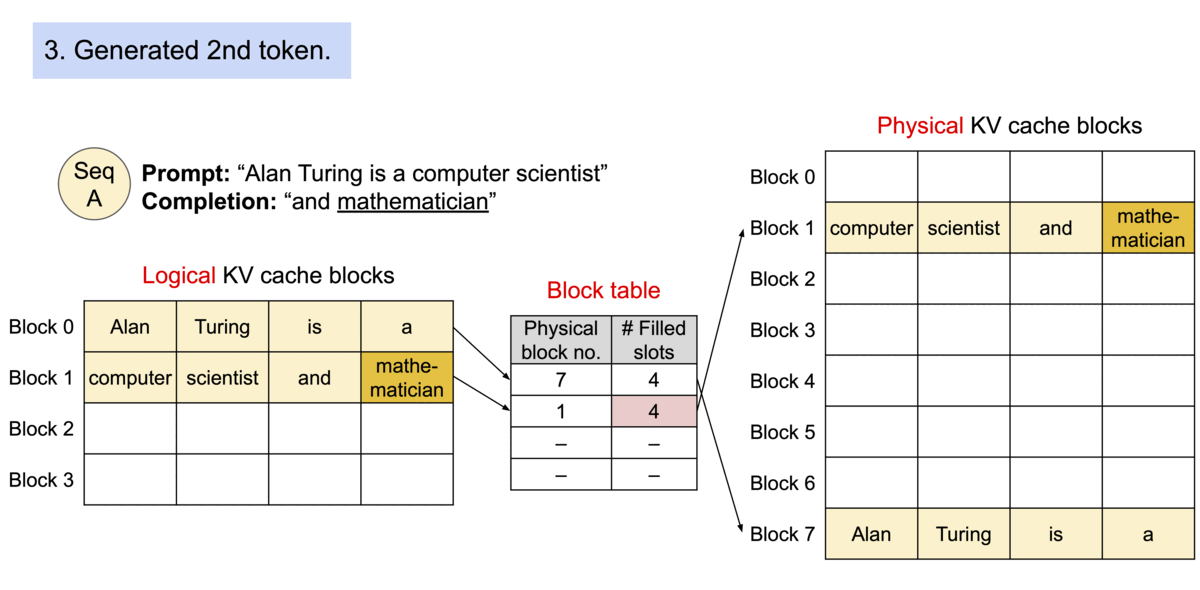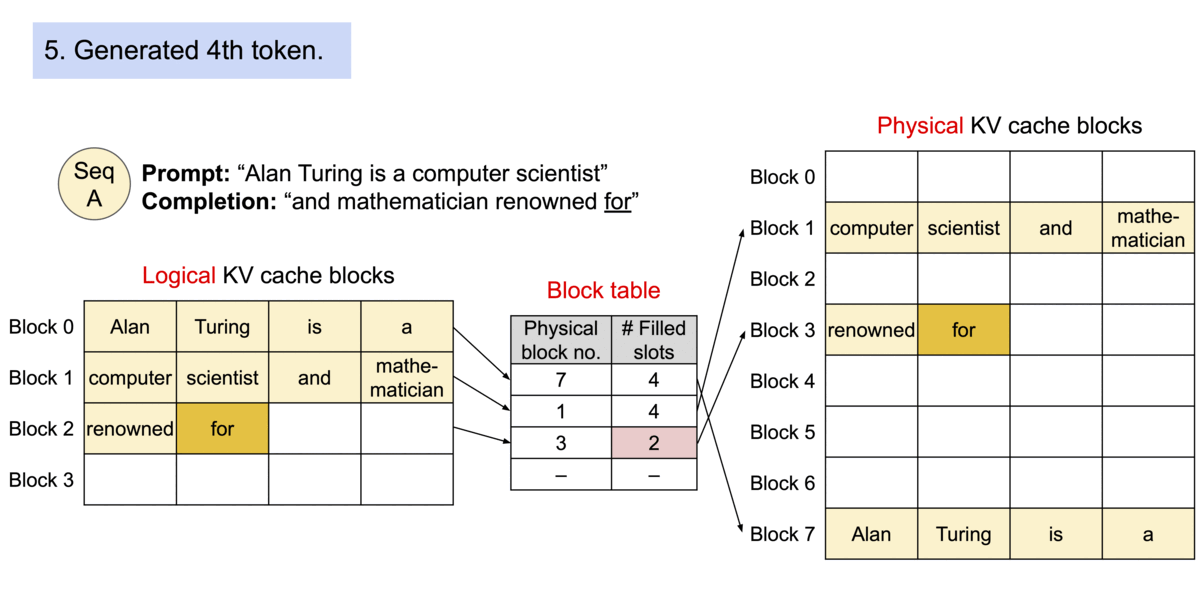
KV 캐시는 이전 토큰의 Key·Value를 보관해 후속 토큰 생성에서 재계산을 줄입니다. 메모리 사용량을 줄이는 기술이라도 토큰을 물리적으로 배치하는 규칙과 어떤 토큰을 축출할지 정하는 규칙은 서로 다른 발명 후보입니다. Intel 미국 공개출원 US20250036876A1 제1항은 토큰별 attention score 이력으로 그룹 중요도를 계산하고, 캐시 토큰 수가 임계값을 초과하면 축출 범위의 저순위 토큰 그룹을 제거하는 방식을 기재합니다. 최초·최근 토큰 보호 범위는 제3항 이후에 추가로 설명되므로 모든 조건을 독립항 하나에 섞어서는 안 됩니다.
반면 Qualcomm 미국 등록특허 US12579063B2 제1항의 출력영향 점수는 attention 가중치만 비교하는 대신, 토큰 i의 가중치 a와 Value V, 현재 출력 O 사이에서 r=‖a/(1−a) × (V−O)‖ 형태의 값을 이용합니다. 토큰 하나를 삭제한 뒤 나머지 가중치를 재정규화하면, 제거 전후 출력의 차이가 이 식으로 나타난다는 점이 중요합니다.
가상 스칼라 예에서 세 토큰의 가중치가 (0.05, 0.20, 0.75), Value가 (100, 10, 10)이면 출력 O는 14.5입니다. 첫 토큰을 제거하면 재정규화 출력은 10으로 변화량 4.5, 두 번째를 제거하면 15.625로 변화량 1.125입니다. 가중치만 보면 첫 토큰이 작지만 출력 영향을 기준으로 보면 둘째 토큰 제거의 영향이 더 작습니다. 이는 식을 검산하기 위한 INTLAW 자체 가상 계산이며 특정 LLM의 실제 정확도·속도 실험은 아닙니다.
따라서 발명자료에는 캐시 블록의 할당/해제, 이력 점수 갱신, 그룹 단위 축출 조건, 출력품질 변화, 요청 길이별 GPU 메모리와 지연시간을 나누어 기록할 필요가 있습니다. Intel 공보는 공개출원, Qualcomm 문헌은 등록공보라는 법적 단계의 차이도 구별해야 합니다.
운영자료를 발명자료로 바꿉니다
평균 비용뿐 아니라 요청 길이별 지연, 메모리 사용, 실패 후 재처리량을 정리하고 변경 전후의 알고리즘 흐름을 함께 준비합니다. 인트로는 운영 지표를 개선한 기술적 원인을 찾아 명세서에서 설명할 구성과 조건을 검토합니다.
두 공보가 점수화하는 대상은 무엇인가
Intel US20250036876A1 공개 제1항은 토큰의 attention score 이력을 토큰 그룹별 중요도로 모은 뒤 저순위 그룹을 축출합니다. Qualcomm US12579063B2 등록 제1항에서는 해당 토큰의 Value가 출력 O와 얼마나 다른지를 attention 가중치와 함께 계산합니다. 따라서 낮은 attention값을 가진 토큰이라고 반드시 가장 먼저 축출할 것은 아닙니다.
| 가상 토큰 | 가중치 | Value | 삭제 후 출력 | 출력 차이 |
|---|---|---|---|---|
| A | 0.05 | 100 | 10 | 4.5 |
| B | 0.20 | 10 | 15.625 | 1.125 |
| C | 0.75 | 10 | 28 | 13.5 |
세 토큰의 합산 출력은 O = 0.05×100 + 0.20×10 + 0.75×10 = 14.5입니다. A의 attention 가중치가 가장 작더라도 값의 영향은 B보다 큽니다. Qualcomm 방식의 핵심은 이처럼 가중치 크기와 출력영향도를 분리하는 계산관계입니다. 수치는 연산을 설명하는 예시이며 실제 모델의 응답품질·처리속도 실측값은 아닙니다.
인트로 인사이트
최적화에서 바꾼 규칙과 적용 조건을 정리하고 같은 요청 조건의 비용·응답 품질·지연시간을 비교하면 개선의 원인을 좁힐 수 있습니다. 특허 검토에서는 이 결과를 자원 배분과 처리 순서에 연결합니다. 서비스 규모가 달라져도 유지할 핵심 관계와 구현별 조건을 구분해야 보호할 범위를 설계할 근거가 됩니다.
관련 자료
특허법인 인트로 AI·소프트웨어팀
관련 전문가: 강대환 변리사